SolarWM开放训练代码、数据与权重:视频世界模型瞄准分钟至小时级实时交互
· 来源:github.com
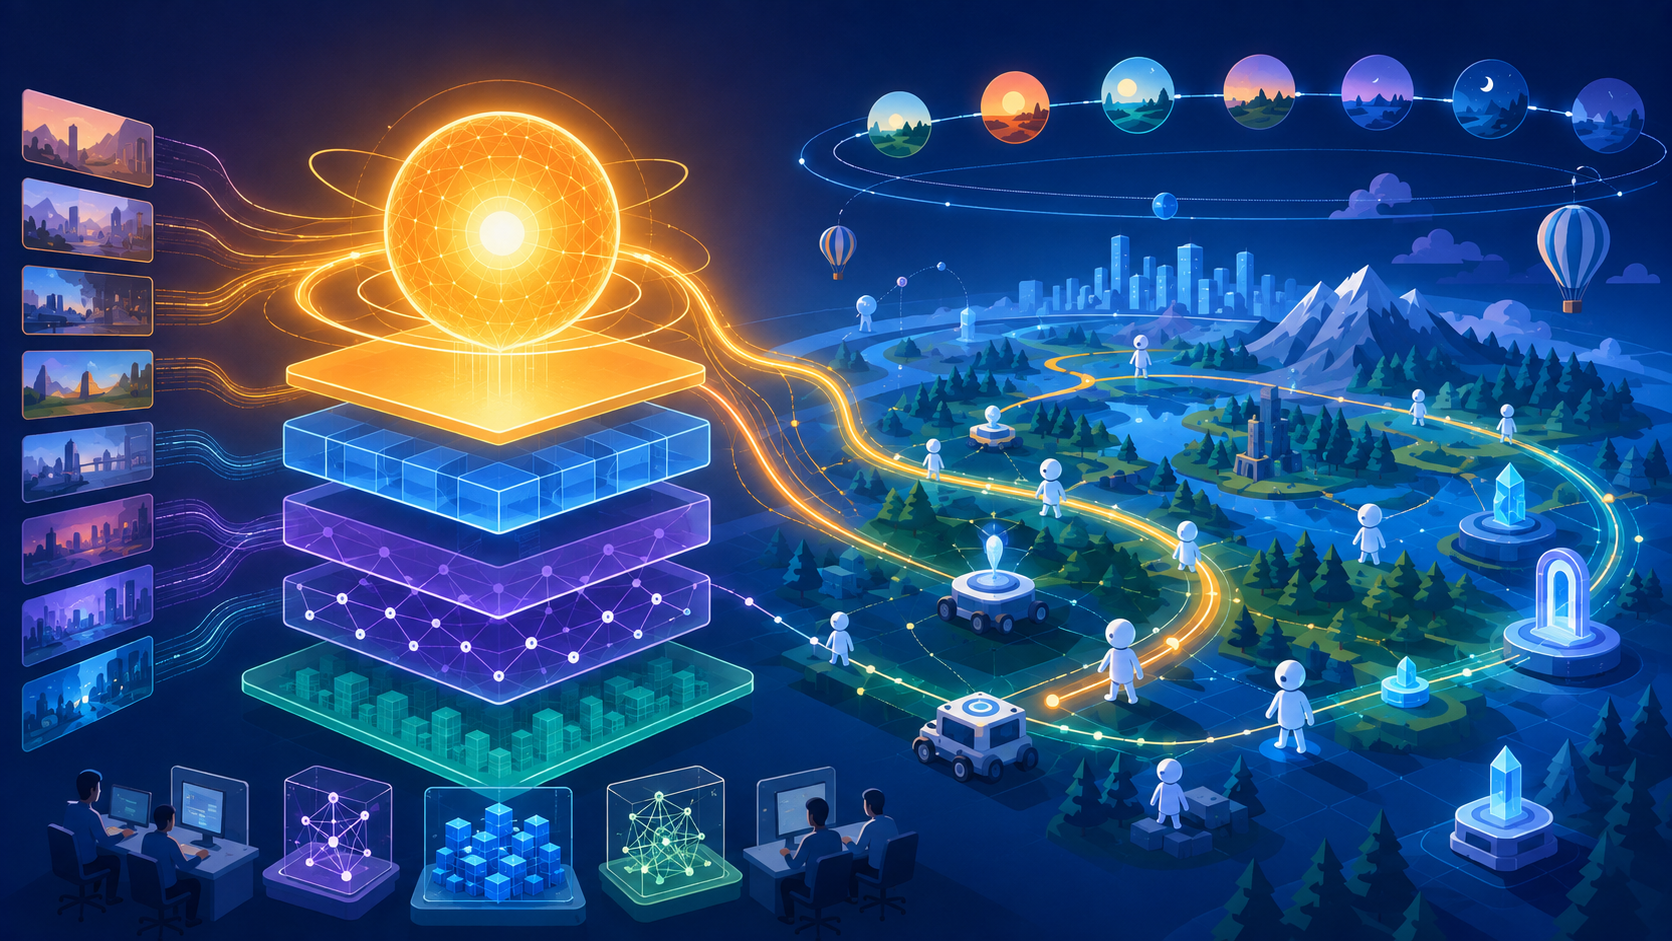
SolarWM发布覆盖数据处理、训练与推理的开放全栈,试图以统一数据接口和分阶段训练,将短视频训练延伸为可持续滚动的交互式视频世界模型。
SolarWM项目近日宣布开源其视频世界模型的训练与推理代码、数据处理管线、部分模型权重及数据集发布组件。该项目由香港中文大学(深圳)、新加坡国立大学、香港科技大学、英伟达、微软亚洲研究院等机构研究者参与,目标是建立从数据准备到大规模训练、再到长时程推理的开放基础设施。项目声称,模型仅在约5秒视频片段上训练后,即可在无需长序列微调或attention sink机制的条件下,进行分钟至小时级的实时交互式视频滚动生成。
与单纯发布模型相比,SolarWM此次开放的重点在于可重配的数据层。项目将来自14个数据集的143万条规范化视频片段,转换为统一的、按帧对齐的数据契约,其中包含观测画面、可度量相机几何信息、文本描述、质量元数据、筛选信息与来源记录。研究团队将原始数据处理与训练数据混合方案解耦,意在让研究者能够按不同训练配方重新选择和组合数据,而非被固定数据集版本绑定。
模型层面,SolarWM提出兼容多种视频生成骨干的统一框架,覆盖Wan2.2、LTX-2.5和MiniMax-H3,并规划了5B至33B参数规模的四类模型。其做法不是将不同骨干强行转换到同一表示形式,而是保留各自原生表示和训练目标,再在上层提供相同的训练流程与运行接口。目前,Wan2.2-5B已列出完整的三个训练阶段支持;14B Wan、LTX和MiniMax-H3的部分后续训练阶段仍标注为“即将推出”。
该训练流程分为三个阶段:首先以双向全片段流匹配建立视频、文本和相机条件表征;随后将教师强制与AnyFlow损失结合,使模型在干净历史帧条件下学习对带噪目标片段去噪及有限步流映射;最后以自梯度强制进行分布匹配蒸馏,让因果学生模型基于自身自回归生成结果训练,同时使用冻结教师和可训练判别器提供约束。项目将这一链路概括为从双向视频模型转换为可由相机控制、少步自回归生成的模型。
开源范围也需要区别看待。SolarWM称将提供SolarWM-5B各训练阶段权重,以及14B、LTX和H3的双向权重;公开数据包则包含发布控制、许可证、训练配方与测试索引、格式样例和标注工具包,并不直接包含完整的原始视频WebDataset或预编码潜变量数据。对于采用预编码数据的训练配方,开发者需另行下载对应的latent版本;原始数据主要面向在线编码、自建潜变量或需要完整处理后视频语料的工作流。
视频生成模型正逐步被用于探索可交互、可预测的虚拟环境,但“长时程”不仅取决于单段视频质量,还取决于滚动生成中人物、场景、相机运动与交互规则能否保持一致,以及系统是否能满足实时反馈。SolarWM开放数据、代码和权重,为外部研究者复现其训练配方、检验长时一致性和延迟表现提供了更完整的条件;不过,其是否能够成为具身智能训练或可靠虚拟仿真的通用环境,仍有待在独立评测、复杂动作控制及跨场景泛化中验证。
—— 综合整理自:GitHub SolarWM项目页、Xu Kang AI技术日报